El 28 de agosto se reveló que el primer centro de entrenamiento de datos para robots humanoides de Beijing —considerado en su momento un modelo para la generación de datos de robots reales a gran escala— había suspendido sus operaciones. Un representante de RoMan Intelligence, operador inicial del centro, describió la medida como una actualización proactiva durante una entrevista con los medios.
El representante señaló que, si bien el centro de Beijing había acumulado decenas de millones de segmentos de trayectoria, la configuración seguía siendo esencialmente un entorno de laboratorio. «Para que la IA corpórea realmente ‘se ponga a trabajar’, los datos deben provenir de escenarios de producción y de la vida cotidiana en el mundo real, no de entornos simulados».
Los datos para la IA corpórea están pasando de la era 1.0 a la 2.0; los datos obtenidos mediante teleoperación en centros de entrenamiento de robots están siendo sustituidos cada vez más por datos recopilados en entornos del mundo real.
Antes de que los robots lleguen a los hogares, la recopilación de datos debe llegar allí primero.
Los desafíos de datos a los que se enfrenta la IA corpórea difieren de los de los grandes modelos de lenguaje (LLM). Mientras que los LLM pueden procesar texto e imágenes de Internet, los robots deben aprender no solo a agarrar una taza, doblar ropa o cambiar las herramientas de una máquina en el mundo real, sino también a comprender el posicionamiento espacial, el contacto físico, la aplicación de fuerza y el estado de los objetos. Este tipo de conocimiento es difícil de extraer de vídeos en línea.
En la «era 1.0» de la recopilación de datos robóticos, los robots, los operadores y los objetos se reunían en instalaciones de entrenamiento fijas. Los operadores utilizaban la teleoperación para hacer que los robots realizaran tareas repetitivas —como agarrar, mover y clasificar objetos— en entornos estandarizados. Aunque este modelo resolvió el problema inicial de generar datos corpóreos y facilitó la gestión, la iluminación fija, los objetos uniformes y los flujos de trabajo preestablecidos no tenían en cuenta variables del mundo real como las inconsistencias de los materiales, la interferencia humana y las condiciones operativas anómalas.
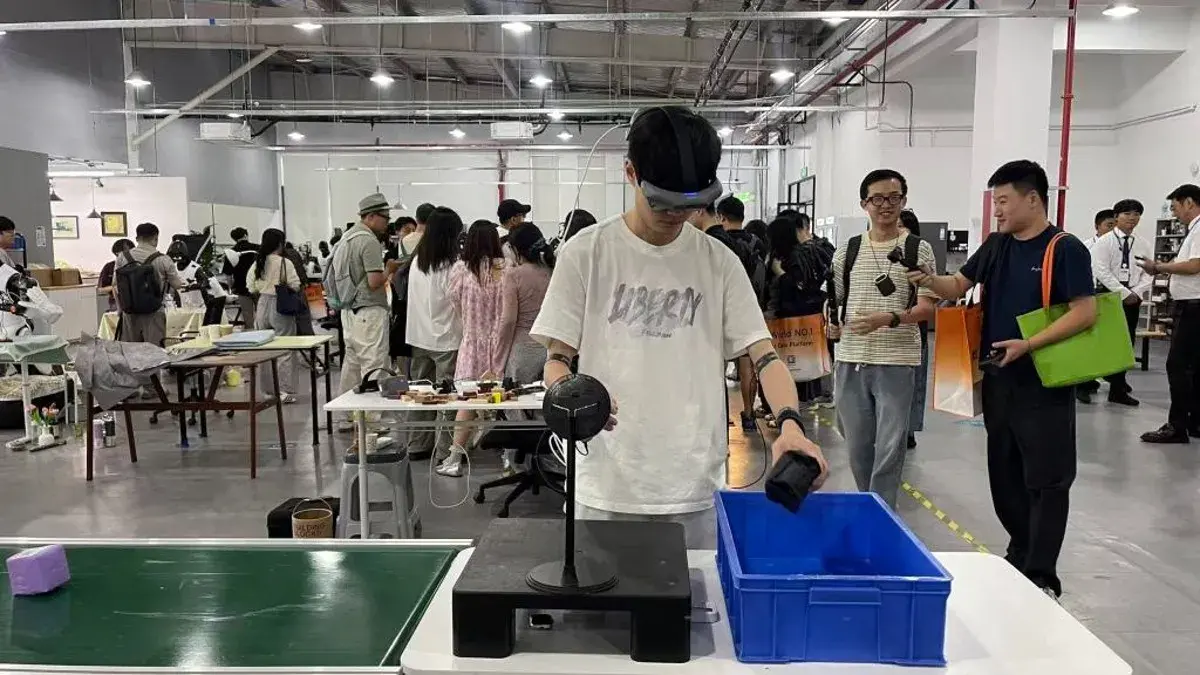
Actualmente, un número creciente de empresas de IA corpórea está distribuyendo equipos ligeros de recopilación de datos a trabajadores a tiempo parcial o completo en diversos sectores, capturando sus movimientos y acciones naturales en entornos domésticos y laborales.
Durante la Conferencia Mundial de Robots de este año, Daxiao Robotics (una empresa de IA corporeizada) presentó su «Solución 2.0 de Recopilación de Datos Basada en el Entorno», un sistema que consta de una interfaz de recopilación, una plataforma de anotación y un sistema de adaptación entre diferentes cuerpos robóticos.
El 26 de agosto, Qiongche Intelligence lanzó una vista previa técnica de su modelo de mundo corporeizado, «Noe-0», junto con una solución de recopilación de datos de extremo a extremo «independiente del cuerpo» (o «agnóstica respecto al cuerpo»). Los recopiladores de datos utilizan dispositivos «RoboPocket» —desarrollados internamente por Qiongche— para registrar tareas como el uso de herramientas, el montaje de componentes electrónicos y la organización de documentos desde tres perspectivas sincronizadas: la cabeza y ambas muñecas. La empresa reveló que esta red distribuida de recopilación de datos abarca más de 50 ciudades en todo el país, habiendo acumulado más de 100.000 horas de datos del mundo real que alimentan un proceso de ciclo cerrado compuesto por preentrenamiento, posentrenamiento y validación con robots reales. En entornos reales, los recopiladores pueden llevar a cabo la captura de datos basándose en la disposición espacial, los objetos y las tareas específicas presentes en el lugar.
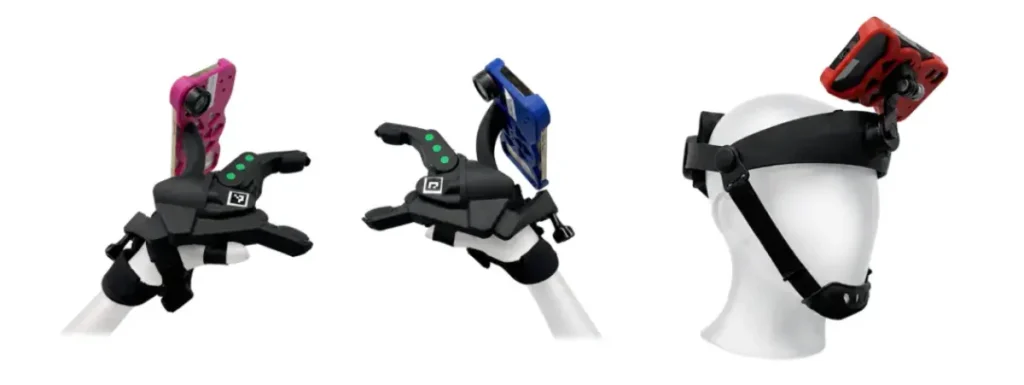
Mifeng Technology también está ampliando el alcance de su recopilación de datos distribuida e independiente del cuerpo. El 31 de agosto, la empresa anunció el despliegue de su unidad número 20.000 del sistema «MEgo» (de recopilación de datos independiente del cuerpo), señalando que ha acumulado más de un millón de horas de datos. El sistema MEgo admite tres modalidades de datos —manos libres, «Ego+Wrist» (montado en la muñeca) y «Ego+UMI» (montado en una pinza robótica)— para satisfacer distintos requisitos de datos, tales como la manipulación humana natural, la postura de la muñeca y las trayectorias de movimiento continuo, así como las operaciones de efectores finales robóticos.
Yao Maoqing, presidente y director ejecutivo de Mifeng Technology, declaró a *The Paper* (www.thepaper.cn) que los dispositivos MEgo ya no se despliegan únicamente en instalaciones dedicadas a la recopilación de datos o en empresas profesionales de externalización de procesos empresariales (BPO); la fuerza laboral ahora incluye a miembros jubilados de la comunidad, madres que se dedican al hogar y profesionales de diversas industrias.
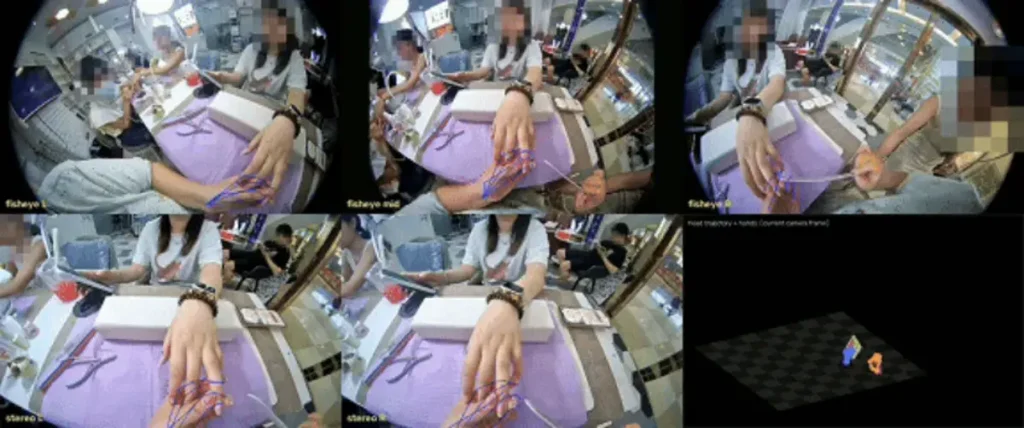
«La recopilación de datos sin necesidad de una plataforma robótica integrada (*embodiment-free*) requiere que los datos fluyan a través de diversos escenarios, industrias y ciudades. Esto implica a una amplia gama de personas que necesitan formación y acceso a entornos del mundo real», señaló Yao. Explicó que escalar la recopilación de datos en el mundo real —pasando del millón de horas actual a cientos de millones de horas— simplemente replicando centros centralizados de recopilación no es realista. Una vía más viable consiste en utilizar dispositivos portátiles y redes de colaboración abierta (*crowdsourcing*) para distribuir las tareas de recopilación entre diferentes regiones y sectores, permitiendo generar datos directamente en entornos reales como hogares, fábricas y tiendas, mientras la plataforma gestiona el diseño de tareas, el control de calidad, el etiquetado y la validación.
Yang Lixin, investigador adjunto y supervisor de máster en la Escuela de Inteligencia Artificial de la Universidad Jiao Tong de Shanghái, considera que, para que los robots de propósito general lleguen finalmente a los hogares, la recopilación de datos debe realizarse también en ese entorno doméstico; además, una implementación a escala industrial exige que la tecnología sea utilizable por el público general, sin necesidad de conocimientos técnicos previos. «Nuestro objetivo es crear un robot de propósito general capaz de prestar servicio a hogares de todo el país, lo que implica inevitablemente que la recopilación de datos deba realizarse en esos mismos hogares».
Del modelo de venta de hardware para recopilación de datos a la creación de infraestructura de datos.
Hasta principios de este año, el ámbito de la recopilación de datos para robótica (*embodied data collection*) se caracterizaba por una mezcla de enfoques técnicos en competencia. Yao Maoqing recuerda que, por aquel entonces, «bastaba con utilizar un teléfono inteligente o una cámara de acción para capturar datos y cerrar una venta». Sin embargo, en la segunda mitad del año, los requisitos comenzaron a estandarizarse en torno a especificaciones como 60 FPS (60 fotogramas por segundo), resolución 1080p, visión binocular y detección de profundidad; al mismo tiempo, los clientes empezaron a priorizar factores como el peso del dispositivo, la capacidad de transmisión inalámbrica, la sincronización temporal y la precisión de la calibración espacial.
Si bien el umbral técnico del hardware para la recopilación de datos se ha elevado, el hardware en sí mismo puede no constituir una ventaja competitiva sostenible a largo plazo. Una vez que los dispositivos se producen en masa, las empresas aún deben reclutar y formar personal, diseñar tareas de recopilación, coordinar operaciones en diversos escenarios y gestionar todo el flujo de trabajo: desde la carga, limpieza, eliminación de duplicados y etiquetado de datos hasta el control de calidad y la validación por parte del cliente. En opinión de Yao Maoqing, la recopilación de datos ha evolucionado hasta convertirse en una compleja tarea de ingeniería de sistemas que involucra a personal, equipos, entornos y relaciones entre datos.
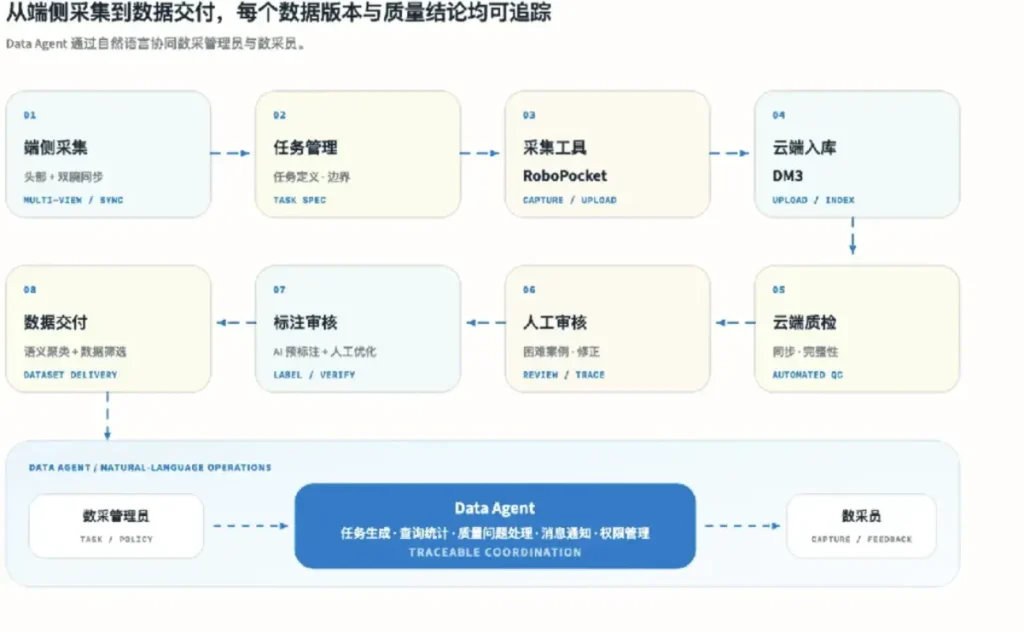
Esto supone un cambio desde un modelo de negocio basado simplemente en la «venta de hardware» hacia uno basado en la venta de «sistemas de ingeniería de datos». Mifeng Technology, por ejemplo, no se limita a vender su dispositivo MEgo; también utiliza el motor MEgo Engine para procesar datos y participa en las operaciones y la ejecución de los escenarios. Del mismo modo, el RoboPocket lanzado por Qiongche Intelligent sirve únicamente como punto de entrada para la recopilación de datos: una vez que los datos ingresan en la plataforma DM3, se someten a comprobaciones automatizadas, revisión manual, pre-anotación mediante IA y filtrado semántico, para luego vincularse a configuraciones de entrenamiento y resultados de evaluación. Los problemas identificados por el modelo se transforman entonces en tareas para la siguiente ronda de recopilación de datos.
Yang Lixin sostiene que lo que le falta actualmente a la industria no es necesariamente *más* cantidad de datos, sino un «bucle de retroalimentación» capaz de convertir continuamente los errores del mundo real en material de entrenamiento: cuando un robot comete un error en el campo, un operador humano debe tomar el control; el proceso de corrección debe registrarse e incorporarse nuevamente al flujo de entrenamiento, seguido del despliegue del modelo actualizado. Él resume este proceso como un ciclo continuo de «prueba y error, corrección de errores y reintroducción de los datos corregidos en el entrenamiento». Si cada robot requiere un operador que lo supervise constantemente, el sistema será difícil de comercializar.
La calidad de los datos no puede medirse únicamente en «horas». «Recopilar a ciegas un millón de horas es, en realidad, bastante fácil —basta con repetir tareas específicas—, pero carece prácticamente de valor», afirma Yao Maoqing. Los datos eficaces no solo deben cumplir con los requisitos de velocidad de fotogramas y calibración, sino también abarcar una gama suficiente de sectores, objetos y tareas, superando finalmente las pruebas de aceptación del cliente y la validación del rendimiento del modelo.
Yang Lixin considera que actualmente resulta difícil formular un conjunto exhaustivo de reglas —que cubra todos los escenarios posibles— para definir qué constituye un dato de alta calidad. «En última instancia, debemos confiar en un modelo para evaluar qué datos son buenos». El producto de una empresa de datos no es la grabación de vídeo en sí, sino los recursos de entrenamiento que un modelo puede procesar para mejorar sus capacidades.
La industria de la recopilación de datos está destinada a evolucionar hacia un mercado de carácter «oligopolístico».
Los ajustes realizados en el Centro de Entrenamiento de Datos para Robots Humanoides de Beijing Shijingshan han suscitado nuevos debates en el sector sobre los modelos tradicionales de recopilación de datos. En los últimos seis meses, las plataformas de datos para IA encarnada (*embodied AI*) de diversas regiones han comenzado a modificar sus estrategias, ampliando gradualmente la recopilación de datos desde entornos de entrenamiento fijos hacia entornos de producción reales.
El 1 de septiembre, el gobierno municipal de Beijing anunció que el renovado Centro de Entrenamiento de Datos para Robots Humanoides de Beijing Shijingshan incorporaría sistemas de captura de campo de luz 4D multivista y modelos del mundo. El centro utilizará datos del mundo real para simular y generar escenarios adicionales, al tiempo que coordina sus operaciones en curso de las fases II y III para integrar la recopilación de datos, la generación de simulaciones, el entrenamiento de modelos, la validación en el mundo real y la aplicación práctica.
Se están produciendo cambios similares en otros lugares. En julio de 2026, durante la Conferencia Mundial de Inteligencia Artificial, el Centro Conjunto Nacional y Local de Innovación en Robots Humanoides y Huawei presentaron un centro modelo para el entrenamiento práctico de IA encarnada. Esta solución combina el despliegue en la nube, el procesamiento de datos y herramientas de desarrollo, permitiendo operar tanto en interiores como en instalaciones de producción reales; de este modo, se vinculan la recopilación de datos, el entrenamiento de modelos, el entrenamiento de robots físicos y el despliegue de aplicaciones.
A medida que las plataformas de datos abarcan un mayor número de etapas del proceso, las barreras de entrada aumentan en consecuencia. Una empresa no solo debe producir en masa equipos de recopilación, sino también organizar al personal encargado de dicha tarea, asegurar el acceso a escenarios reales, construir sistemas de almacenamiento y procesamiento, y gestionar la gobernanza de datos, la evaluación de modelos y la entrega a los clientes. La transición de la recopilación de datos —de ser un negocio centrado en el equipo a uno centrado en la infraestructura— implica que el capital y las capacidades de ingeniería y operativas cobrarán una importancia creciente.
Yao Maoqing prevé que la industria terminará evolucionando hacia una estructura de mercado «oligopolística». Su razonamiento se basa en que la recopilación de datos es, por naturaleza, un negocio que requiere una gran inversión de capital y que valora especialmente la experiencia operativa y de ingeniería sistemática, así como la solidez financiera. «Desplegar decenas de miles de unidades exige una inversión inicial de cientos de millones, mientras que construir un centro de datos cuesta miles de millones; por tanto, las empresas líderes poseen inevitablemente una ventaja significativa», señaló Yao.
Esta tendencia de concentración del mercado en manos de los principales actores es especialmente acusada mientras los estándares de datos permanecen sin unificar. «Cuando una empresa modelo utiliza datos obtenidos en primera persona de múltiples proveedores simultáneamente, resulta difícil garantizar la calidad de los resultados del entrenamiento combinado. La contratación centralizada ayuda a mantener la calidad de los datos; Yao ha observado que algunos clientes del sector están reduciendo su número de proveedores, pasando de un enfoque de ‘probar un poco de todo’ a consolidar su actividad con uno o dos proveedores únicamente.
Yang Lixin también considera que la IA corporeizada (*embodied AI*) requiere específicamente la sinergia entre hardware, software y datos; depender exclusivamente de soluciones fragmentadas provenientes de múltiples proveedores dificulta el establecimiento de un ciclo cerrado de datos eficaz. Las empresas que finalmente triunfen serán aquellas que posean capacidades integrales (*full-stack*), es decir, que sean capaces de establecer un ciclo de datos que abarque el despliegue, la aparición de errores, la intervención humana (toma de control), la retroalimentación de datos, el entrenamiento del modelo y el redespliegue.