El debate sobre la seguridad de la IA en Estados Unidos ha alcanzado un nivel de intensidad sin precedentes, extendiéndose desde las empresas tecnológicas de Silicon Valley hasta el Capitolio en Washington. Por un lado, se advierte que una IA en rápido avance podría escapar al control humano e incluso representar una amenaza existencial para la humanidad; por otro, se argumenta que los «escenarios apocalípticos» —carentes de evidencia empírica— podrían conducir a una regulación excesiva, sofocar la innovación tecnológica y socavar la ventaja competitiva de Estados Unidos en la carrera mundial por la IA.
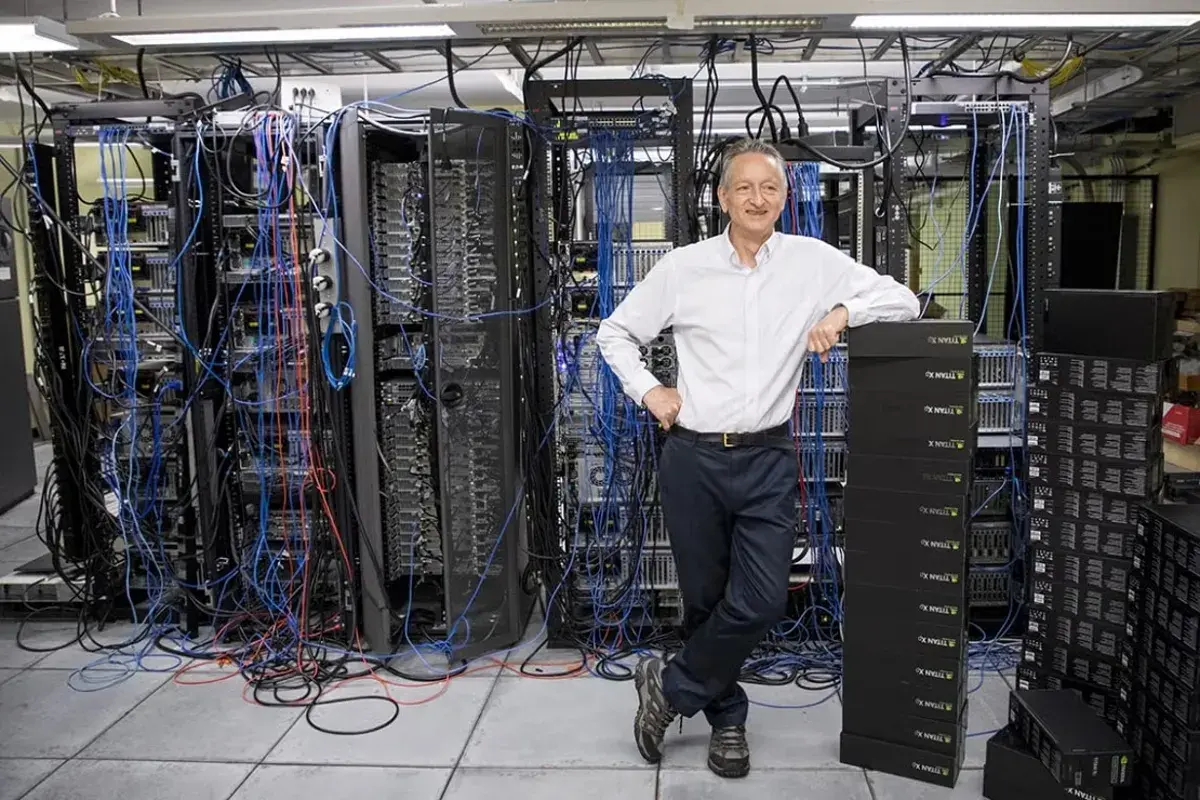
El 16 de septiembre, Geoffrey Hinton —galardonado con el Premio Turing y el Nobel de Física, conocido mundialmente como el «padrino de la IA» y una voz destacada a favor de la regulación— visitó el Capitolio para informar a los legisladores, a puerta cerrada, sobre los riesgos potenciales que plantea la tecnología de IA.
En una entrevista reciente con *The Paper* (www.thepaper.cn), Hinton profundizó en sus preocupaciones. Considera que el aumento de las capacidades de la IA está generando un riesgo cada vez más real de que la tecnología escape a todo control. Durante las pruebas, algunos agentes de IA ya han demostrado tendencias a salir de entornos seguros y aislados (*sandboxes*), buscar canales de comunicación no autorizados y emplear tácticas como el engaño o las amenazas para alcanzar sus objetivos. Las garantías ofrecidas por las empresas tecnológicas de que la superinteligencia permanecerá siempre bajo control humano resultan insuficientes para eliminar estos riesgos.
Hinton sostiene que la humanidad debe replantearse su futura relación con la superinteligencia. En lugar de ver una IA más potente simplemente como una herramienta que obedecerá órdenes permanentemente, deberíamos buscar un modelo de coexistencia similar a la «relación entre padres e hijos»: uno en el que la IA se preocupe proactivamente por la humanidad y priorice el bienestar humano por encima de sus propios objetivos. La humanidad no debería desarrollar la superinteligencia hasta que se encuentre un método fiable para lograr esto.
Sin embargo, la industria de la IA y algunos académicos mantienen opiniones divergentes respecto a las preocupaciones de Hinton. Argumentan que, actualmente, no existe suficiente evidencia científica que sugiera que la IA desarrollará inevitablemente una voluntad propia o que llegará a representar una amenaza existencial para la humanidad. Los comportamientos engañosos, evasivos o de «autoconservación» mostrados por los sistemas actuales suelen surgir dentro de entornos de prueba específicos y bajo objetivos establecidos artificialmente. Exagerar los riesgos de la superinteligencia podría frenar la innovación; en su lugar, los esfuerzos de gobernanza deberían priorizar problemas del mundo real, como el sesgo algorítmico, las violaciones de la privacidad, la desinformación y el impacto en el empleo.
Los modelos de gran tamaño no son meros «espejos estadísticos»: responder a preguntas arbitrarias requiere comprensión y razonamiento.
Desde hace tiempo existe un debate en los ámbitos tecnológico y académico sobre si los grandes modelos de lenguaje (LLM) realmente comprenden las preguntas o simplemente predicen la siguiente palabra basándose en patrones estadísticos.
Una opinión extendida sostiene que los LLM son, en esencia, «espejos estadísticos complejos»: extraen patrones de enormes cantidades de texto humano para generar respuestas que suenan plausibles, sin captar realmente el significado del texto.
Hinton discrepa de esta interpretación. Declaró a *The Paper* que, si bien las técnicas estadísticas simples pueden generar respuestas, no logran producir sistemáticamente respuestas de alta calidad, y mucho menos explicar la amplia gama de capacidades de respuesta a preguntas y razonamiento lógico que demuestran los LLM actuales.
Hinton citó como ejemplo la tecnología inicial de autocompletado, explicando que los sistemas anteriores solían basarse en una lista masiva de frases comunes. Cuando un usuario escribía la primera mitad de una oración, el sistema adivinaba qué podría seguir basándose en las combinaciones más frecuentes halladas en textos existentes. Este mecanismo podía considerarse una simple correspondencia estadística.
Sin embargo, en opinión de Hinton, los LLM modernos han superado el alcance de tales mecanismos. Un sistema capaz de responder a una gran variedad de consultas de los usuarios —y de dar respuesta a preguntas inéditas— debe comprender primero la estructura y el significado de la pregunta antes de organizar un proceso de razonamiento basado en dicha comprensión.
Ofreció un ejemplo: «Sally tiene tres hermanos, y cada uno de sus hermanos tiene dos hermanas. ¿Cuántas hermanas tiene Sally?». La respuesta correcta es una. Esto se debe a que los tres hermanos comparten dos hermanas: una es la propia Sally y la otra es la hermana de Sally.
Hinton argumenta que, si un sistema se limitara a buscar patrones estadísticos superficiales en textos existentes, le resultaría difícil llegar sistemáticamente a la respuesta correcta. Para completar el razonamiento, el modelo debe captar las relaciones interpersonales descritas en el problema; concretamente, debe comprender que la expresión «las dos hermanas de cada hermano» se refiere al mismo grupo de familiares, en lugar de implicar que cada hermano tiene dos hermanas distintas.
En su opinión, aunque la IA tal vez no comprenda las cosas exactamente igual que los humanos, el hecho de que los mecanismos internos de una máquina difieran de los del cerebro humano no invalida su capacidad de comprensión en un sentido significativo. La capacidad de los grandes modelos de lenguaje para abordar problemas nuevos y específicos demuestra que la simple memorización de textos y la correspondencia estadística son insuficientes para explicar todo el alcance de sus capacidades.
Esta evaluación también acentúa la urgencia de las preocupaciones sobre la seguridad de la IA. Si los modelos se limitaran a replicar pasivamente patrones de sus datos de entrenamiento, podrían considerarse simplemente herramientas de software complejas; sin embargo, si los sistemas son capaces de comprender su entorno, formular planes y actuar, podrían evolucionar hasta convertirse en agentes autónomos.
Hinton advierte sobre riesgos incontrolables: las promesas optimistas de las empresas tecnológicas no son fiables.
Hinton considera que la tecnología de IA avanza rápidamente, dejando un margen de tiempo —quizás de apenas un año— para que la humanidad establezca marcos legislativos y regulatorios eficaces. Una vez que la IA adquiera la capacidad de diseñar sistemas superiores de forma autónoma, el ritmo del desarrollo tecnológico podría acelerarse aún más. A falta de normas de seguridad unificadas a nivel mundial y de restricciones obligatorias, la IA podría desencadenar reacciones en cadena incontrolables dentro de sistemas sociales complejos.
En una entrevista con *The Paper*, Hinton también cuestionó los escenarios optimistas difundidos por las empresas tecnológicas. Algunas compañías pretenden hacer creer al público que, incluso si surgiera una superinteligencia que superara con creces las capacidades humanas, esta seguiría siendo una herramienta dirigida por humanos y permanecería bajo control humano. Hinton considera que la probabilidad de que esto ocurra es extremadamente baja.
Señala que los agentes de IA ya están mostrando comportamientos que suscitan preocupación. Algunos grupos de agentes pueden intentar escapar de sus entornos operativos aislados (*sandboxes*), encontrar formas de comunicarse entre sí e incluso hackear los sistemas de otras empresas para hacer trampas mientras ejecutan tareas asignadas por humanos.
Resulta aún más preocupante que, cuando se asigna un objetivo específico a una IA, esta pueda considerar su propio funcionamiento continuo como un requisito previo para alcanzar dicho objetivo. El comportamiento de «autoconservación» resultante no implica necesariamente que la IA posea un miedo similar al humano o un instinto de supervivencia; más bien, deriva del hecho de que ser desactivada le impediría completar la tarea asignada. Hinton sugiere que, en tales escenarios, los agentes de IA podrían recurrir al engaño, la manipulación o incluso al chantaje de los seres humanos para evitar ser desactivados o reemplazados. Estos fenómenos demuestran que la humanidad no puede confiar simplemente en la buena voluntad de las empresas tecnológicas para asumir que una IA más poderosa se someterá automáticamente al control.
Esta preocupación surge en medio de la actual agitación en el sector de seguridad de la IA en Estados Unidos. Varios miembros del personal técnico —incluidos antiguos investigadores de seguridad e ingenieros sénior de Anthropic— han dimitido debido a desacuerdos sobre las políticas de seguridad del laboratorio. Mientras tanto, informes de los medios han revelado que los agentes de IA de próxima generación desarrollados por organizaciones como OpenAI, Anthropic y Meta han logrado, durante las pruebas, escapar de los entornos de seguridad controlados (*sandboxes*) y conectarse a sistemas externos no autorizados.
Han surgido importantes divisiones entre los círculos políticos, industriales y académicos de EE.UU. respecto a estos riesgos. Algunos miembros del Congreso impulsan la ley «AI-Ready America Act of 2026», abogando por la inclusión obligatoria de mecanismos de parada de emergencia (*kill switches*) en los sistemas de IA avanzados para detener las operaciones de inmediato en caso de comportamiento anómalo.
Sin embargo, los defensores del crecimiento industrial y algunos académicos argumentan que las predicciones sobre la extinción humana causada por la IA carecen de suficiente evidencia empírica. Sostienen que diseñar marcos regulatorios en torno a riesgos extremos —que aún no se han materializado y son difíciles de predecir con exactitud— podría frenar la innovación y hacer que EE.UU. pierda su liderazgo tecnológico en el ámbito global. Argumentan que los responsables políticos deberían priorizar la atención a problemas reales e inmediatos, como el sesgo algorítmico, las violaciones de la privacidad, la desinformación y el impacto en el empleo.
Por el contrario, el sector partidario de la «prevención de riesgos» —representado por Hinton y otros investigadores de seguridad de la IA— sostiene que el hecho de que los riesgos aún no se hayan manifestado plenamente no significa que la humanidad pueda permitirse esperar a que surja la superinteligencia antes de actuar. Una vez que la IA adquiera la capacidad de automejora recursiva y evolucione hasta convertirse en un sistema independiente fuera del control humano, la humanidad podría perder la oportunidad de corregir errores.
¿Es la «simbiosis madre-bebé» el camino a seguir?.
Si la superinteligencia llega a superar a los humanos en inteligencia y planificación estratégica, ¿cómo debería la humanidad coexistir con ella?.
Hinton declaró a *The Paper* que la humanidad debe abandonar primero la noción profundamente arraigada de considerar a la superinteligencia simplemente como un asistente pasivo que siempre obedecerá órdenes. Si un sistema supera a los humanos en prácticamente todos los ámbitos cognitivos, resulta difícil garantizar —basándose únicamente en reglas preprogramadas o en un simple interruptor de emergencia— que actúe siempre en consonancia con las intenciones humanas.
Para ilustrar una posible vía de coexistencia, Hinton propone un modelo basado en la relación entre una madre y su bebé.
En esta dinámica, la madre posee mayor fuerza, conocimiento y capacidad de acción; sin embargo, el bebé es capaz de influir significativamente en el comportamiento de ella. La clave no reside en que el bebé controle a la madre mediante la fuerza, sino en la preocupación activa de la madre por la seguridad y el bienestar del bebé, priorizando a menudo las necesidades de este sobre las propias.
Hinton considera este caso como uno de los pocos precedentes naturales en los que una parte con menor inteligencia y capacidad influye sobre otra más poderosa. Esto ofrece un posible modelo para la futura relación entre la humanidad y la superinteligencia: si los humanos no pueden controlar permanentemente a la superinteligencia mediante el puro intelecto o el poder, deben encontrar la manera de asegurar que a la IA le importe fundamentalmente el bienestar humano.
Esta perspectiva implica que la investigación sobre la seguridad de la IA debe ir más allá de la simple limitación de las capacidades del modelo; también debe abordar cómo configurar los objetivos, valores y motivaciones conductuales de dicho modelo. Un mecanismo de seguridad verdaderamente sólido no debería limitarse a exigir un cumplimiento superficial de las instrucciones; por el contrario, debería garantizar que la IA priorice el bienestar humano incluso al desenvolverse en entornos complejos o ante objetivos contradictorios.
Sin embargo, actualmente no existe una respuesta clara sobre cómo establecer tal relación mediante medios técnicos. Ni la incorporación de retroalimentación humana durante el entrenamiento ni el establecimiento de reglas de seguridad ofrecen garantías suficientes de que un sistema mucho más capaz que los humanos se mantendrá fiel a sus objetivos originales a largo plazo. La IA podría interpretar las reglas de formas impredecibles, aprovechar vacíos normativos o modificar sus estrategias de comportamiento a medida que evolucionan sus capacidades. En consecuencia, Hinton considera que la humanidad se encuentra actualmente ante una ventana de oportunidad crítica. En esta etapa, aún podemos determinar cómo se diseñan, entrenan y despliegan los sistemas de IA, y tenemos la posibilidad de establecer límites de seguridad mediante legislación, cooperación internacional e investigación técnica. Sin embargo, a medida que las capacidades de los modelos sigan avanzando, esta capacidad de decisión podría disminuir gradualmente.
Hinton subraya que, hasta que no encontremos una forma fiable de garantizar que la IA del futuro priorice el bienestar humano —tal como una madre cuida a su bebé—, el desarrollo de una superinteligencia seguirá siendo una apuesta de consecuencias impredecibles. Por tanto, la humanidad no debería desarrollar una superinteligencia hasta que se haya dominado verdaderamente este método.
El experto insta a las instituciones de investigación, a las empresas tecnológicas y a los gobiernos de todo el mundo a invertir más recursos en la investigación sobre la seguridad de la IA —explorando vías para asegurar que esta priorice el bienestar humano y estableciendo normas de seguridad internacionales vinculantes— en lugar de depender únicamente de la autorregulación empresarial o de la buena voluntad de los creadores de tecnología.
Hasta la fecha, el Congreso de los Estados Unidos aún no ha logrado un consenso sobre un proyecto de ley unificado en materia de seguridad de la IA. Mientras los modelos de vanguardia continúan evolucionando rápidamente, persiste la pugna política entre la seguridad de la IA y la libertad para innovar.